读书,其实就是一场“脑蒸馏”

最近想到一个有意思的比喻:读别人的书,本质上就是在给大脑做“知识蒸馏”。

比如你读爱因斯坦,这就相当于你在蒸馏他。

在AI领域,蒸馏就是小模型向聪明的“大模型”学习。人脑之间的蒸馏和AI模型是一样的规律:你蒸馏了大模型(伟人),确实能迅速提高你在某些特定领域的水平。

但这有一个瓶颈——你的整体水平,最终受限于你本身“模型”的能力和规模。

我们作为普通的小模型,可以学到大模型输出的结果和推导过程,但没法复刻他产生这些结果的底层思维机制。所以,我读了再多爱因斯坦,也不可能成为爱因斯坦。

既然自身模型能力决定了上限,那普通人蒸馏大模型还有什么用?顺着这个比喻,我觉得“小模型”有三种自己的玩法:

  1. 混合蒸馏
    AI往往是一对一蒸馏,但人可以多路并行。可以同时蒸馏爱因斯坦的理性和苏轼的豁达。多蒸馏几个不同领域的大模型,拼凑起来,小模型就成了一个独一无二的综合体。
  2. 动态扩容
    AI小模型的参数量是写死的,但人脑有神经可塑性。经常去蒸馏高质量的内容,大脑的认知结构会改变。也就是说,通过持续学习,自身的“基础参数量”是会慢慢变大的。
  3. 目标是微调(Fine-tuning)
    我们蒸馏别人,目的从来不是把自己复制成另一个爱因斯坦。而是把前人最优质的数据拿来“微调”自己,优化自己面对生活的算法。

想通了这点就不焦虑了。接受自己是个普通模型,不去死磕天花板;然后不断去蒸馏更好的前人,把自己的模型调优到极限就好。
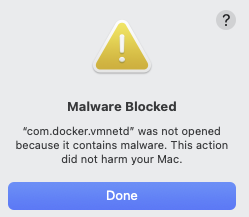
“com.docker.vmnted” was not opened because it contains malware 问题解决

好久没有在Mac下用Docker,今天用docker的出现如下提示框:
“com.docker.vmnted” was not opened because it contains malware. This action did not harm your Mac.

关掉没有用,会反复出现。 把机器重启,重装docker都没用, 在网上查了半天,发现没一个网页记录了完整的解决方法,我这里记录下自己是怎么解决的。

  1. 先要完整的卸载Docker。
    • 可参见Docker给的卸载文档, 但文档里说的也有问题, 比如文档里说通过在命令行执行 /Applications/Docker.app/Contents/MacOS/uninstall 来卸载,但在我机器上执行这个命令会死在那里,一直不动。 最后没办法,只好手动从Application文件夹里把Docker卸载了
    • 然后按文档执行下面命令
      rm -rf ~/Library/Group\ Containers/group.com.docker
      rm -rf ~/.docker
    • 最关键是删除下面两个文件
      sudo rm -f /Library/PrivilegedHelperTools/com.docker.vmnetd
      sudo rm -f /Library/PrivilegedHelperTools/com.docker.socket
  2. 然后重新安装Docker Desktop for Mac
  3. 但安装完别着急运行,先执行下面的命令:
    sudo cp /Applications/Docker.app/Contents/Library/LaunchServices/com.docker.vmnetd /Library/PrivilegedHelperTools/
  4. 按照以上步骤,你应该能顺利解决 Docker 启动问题。如果还有问题,可以尝试重启电脑后再运行 Docker。

保障计算机安全的责任应该由用户来承担么?

现在用的操作系统是Vista, 经常会弹出对话框,要求审批是否给予一些应用程序以管理员权限。 为了安全还安装了一个防火墙和杀毒软件,经常会弹出对话框要求确认是否允许一些程序运行,允许程序访问互联网,允许程序存取关键目录和文件。 这些需要审核的对话框有时弹出的太频繁,让人不胜其烦,只能看都不看直接点允许。 这些对话框有时提示的信息太晦涩,看不明白啥意思,拿不准是该批准还是拒绝。 对我这个IT技术人员还如此困难,对非IT专业人员的使用难度可想而知。

当计算机安全的挑战越来越大时,微软和杀毒软件厂商们把大量判断的责任推给用户们,这样一旦出了问题可以推卸责任,说是用户的选择错误,而不是软件问题。 难道计算机安全的责任只能由最终用户来承担么? 最终用户能承担好这个责任么?

用iphone写blog

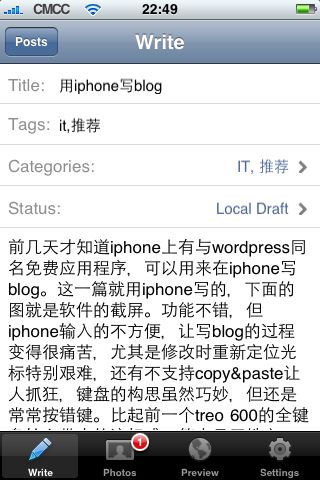
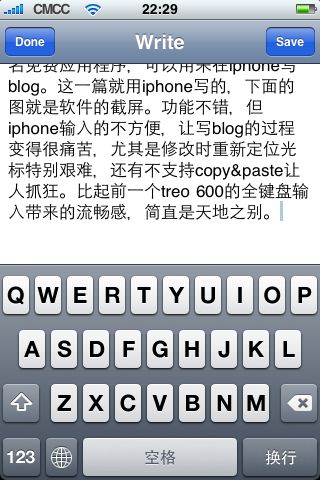
前几天才知道iphone上有与wordpress同名的免费应用程序,可以用来在iphone上写blog。这一篇就是用iphone写的,下面的图就是软件的截屏。软件功能不错,但iphone输入的不方便,让写blog的过程变得很痛苦,尤其是修改时重新定位光标特别艰难,还有不支持copy&paste让人抓狂,键盘的构思虽然巧妙,但还是常常按错键。比起前一个treo 600全键盘输入带来的流畅感,简直是天地之别。

虽然输入不便,但还是很喜欢iphone。刚才朋友短信过来自己女儿满周岁照片的网上相册地址,点短信中的链接就直接跳到picasa网上相册,显示效果非常完美。一张张翻看小天使的照片,仿佛手中的iphone真的成了相册,看得非常惬意。

平常最常用的还有stanza电子书软件,结合网上图书馆室,iphone又成了让人爱不释手的书。

平常跑步锻炼就用trackthing,统计跑的距离和速度,还不够好,不过magico已经答应要做个更好的iphone跑步软件给我,条件是将来拿了马拉松冠军奖金要分他一半。

写上面这点文字已经用去了一个多小时,iphone看来还是不适和作为日常的blog书写工具,但用来发一些以图片为主的blog(如突发新闻事件播报),应该还是可以大有作为的。

更新:被magico鄙视了,修改时定位光标原来一点都不难:对着想定位光标的文字,按1秒钟以上,出来一个放大镜,然后稍微移动手指,看着光标在放大镜里跟着动,很容易就能定位了。

用下载来上载

从大约两个月前,用家里的电信小区宽带FTP上载到美国服务器速度就奇慢,一般速度只有2K-4K字节每秒,而且不稳定,经常断。 上传45M的文件,有时要上传一整天。 用VPN登陆到美国服务器则更糟糕,往往是开头挺快,30K-40K,传了几兆后就跌到1K-2K。 下载都很正常,用FTP下载美国服务器上的同一个文件,单线程能到20K的速度,多开几个能到100K。下载国内的就更快了,用快车最快能到500K。

今天上载又是特别艰难。凌晨3点用Cuteftp pro开始上载后就去睡了,本以为醒了后就上载完了,起来一看才20%多。不着急,等着吧。到中午已经到了97%,正乐着呢,没想到又突然跳回1%开始上传!抓狂!

即将气得要砸了电脑的时候,突发奇想,用终端登录到美国的服务器,然后在自己的台式机上启动apache,从美国服务器用wget下载自己台式机上的文件,速度好多了,一直保持在15K。后来不满足,在网上找了个linux下的多线程下载myget,但是无论开启多少个线程速度也是15K的样子,唯一的亮点是能断点续传。只好死了多线程的心,一直等到wget下载完,45M用了半个多小时,谢天谢地中间没断。

大家有啥更好的办法赶紧教教我。


另:这个上载速度慢的问题,怀疑和GFW有关,不过现在还没啥证据。

网站流量分析行业的薪资水平

前一阵webanalyticsdemystified.com做了一个网站流量分析行业工资水平的调查,调查结果昨天发布了。调查主要是在美国,调查出的平均年薪是$86,883(美元,税前,下同)。低于$50,000的是18%, 还有10%是高于$150,000。 有5年以上经验的,平均年薪是$102,544。 从2005年2月3日到2007年9月27日,发布在indeed.com上要求具有网站流量分析技能的招聘广告已经有了近275%的增长 (在51job.com则一个都没搜索到)。

调查报告在 Web Analytics Salaries 2007: Insights and Observations (PDF 格式)

调查的数据可以在 Web Analytics Salary Data 查询。

等合适的时候也做做国内的网站流量分析行业的薪资水平调查。

如何用Google Analytics跟踪出站点击

有时候我们需要知道用户是点击了站点中哪个外部链接离开了你的站点。比如当你的购买链接是指向第三方的收费代理,这时候就很有必要知道有多少用户是点击了购买链接离开了你的站点. 单靠平常的在线统计日志分析(Log Analysis)是不能跟踪的,因为很多时候外部站点不允许你插入统计代码,更不会给你看日志文件。这时候就需要我们动手加点东西来实现对出站点击的跟踪。

以前追踪出站点击的方法主要就是不直接链接到外部站点,而是链接到一个本地文件上,把用户的出站点击经这个文件中转一下。这样通过日志分析(Log Analysis)统计中转文件的访问,或直接由这个中转文件把统计结果写入数据库, 以此来实现对出站点击的跟踪。

那么用Google Analytics如何跟踪出站点击呢?有人要说可以在中转文件中插入Google Analytics的代码,实际上有个更简单的办法。 在普通网页统计插入的Google Analytics代码中,最后要调用不带参数的urchinTracker() 函数。其实这个函数是可以带参数的。查看http://www.google-analytics.com/urchin.js这个文件,你会发现这个参数名是page,再向下多看看你就很容易发现,这个page参数就是统计页面的url。 利用这个函数就可以实现对出站点击的追踪了,将每个出站链接加入如下代码:

<a href=”http://www.waibu.com” onClick=”javascript:urchinTracker(/outgoing/1);”>链接</a>

这个链接中给出的参数’/outgoing/1‘ 是可以根据自己需要定制的,并不是站点中必须要有的文件。urchinTracker 这个函数你只要给他什么参数他就统计什么,实际是否存在并不关心。 加入这段代码后,一旦用户点击,Google Analytics就会记录为一个对’/outgoing/1‘的访问。这样你只用每天看Top Content(最常见内容)报表中’/outgoing/1‘ 的访问数字就能知道点击这个外部链接的访问有多少了。 你还可以把’/outgoing/1‘ 定义为一个目标(Goal),在Google Analytics对目标的转化率Conversion Rate(转化率),Goal Path(目标访问路径)等进行分析。

注:

1.这种跟踪方法在不支持或禁止javascript的客户端是无效的
2.这种跟踪方法的前提是你必须在网页中安了Google Analytics统计代码